任务
拿到一个安装包,要求做到四件事:
- 搞清楚该类型安装包的具体名称;
- 搞清楚它的内部信息存储结构,尝试解析存储结构中字段的含义,并用结构体实现相关定义;
- 搞清楚该安装包内嵌文件的存储方式,以及如何还原出内嵌文件;
- 在前两步的基础上,通过代码实现该类型安装包的解包程序——输出包内部信息,甚至还原出包内的内嵌文件。
第 1 条的答案这篇不写,所以下面所有截图和描述都只到「某类安装包」这一层。留着的只有方法路径、偏移量、结构体字段,以及几个我自己踩过的判断。原始样本只以 GPG 加密的形式随仓库发布。
这四条的排列本身就值得说一句:它是一条从"这是什么"到"我能复刻"的递进链,而不是四个并列的问题。名称和结构是认知,存储和还原是操作,最后代码只是把前三步的结论固化下来。做的时候如果跳过 2 直接奔 4,写出来的东西通常只对眼前这一个包成立。
一、寻找 buf
既然是安装包,资源肯定在自身。
第一反应是走 PE 资源:安装包嘛,图标、版本信息、对话框都在资源段里,内嵌文件大概也在那。打开资源看了——没有找到有用信息。这条路是死的,划掉。
那数据在哪?线索是一个更笨的东西:**EXE 的体积不正常。**一个功能不复杂的客户端,装它不需要几十兆。资源段里没有、体积又明显超出,那就只剩一种可能——数据直接存储在标准结构之后,追加在文件尾部。
这个判断不需要任何工具,看一眼文件大小就够了。但它决定了后面所有动作的方向:既然数据是"贴在可执行体后面"的,那就别在静态结构里翻了,去看程序运行时怎么读自己。
于是下断 CreateFileW,找其中读取自身的那几条;再下断 ReadFile,同样找读取自身的那几条。这里有个很实际的时间账:前面几轮读取全是运行库和配置文件的初始化,直接快步放行,别一上来就单步,会白白耗掉大量时间。
放行掉初始化之后,buf 就出来了。而且有一个极好用的旁证:
每进行 2 次
ReadFile,都会出现一个新文件。
这句话的价值比它看起来大得多。“读两次 → 产出一个文件"稳定重复,说明外层存在一个以文件为单位的循环,且每次循环内部有两次读取。不用看懂一行代码,光数调用次数就能确认循环骨架的存在。这是整个分析里性价比最高的一次观察。
还有一条否定性结论同样值钱:拿 010 Editor 直接在 EXE 里搜内嵌文件的明文,没有找到目标文件。这说明"文件实际内容"和"存储在 EXE 里面的数据"不一致,中间一定有某种变换(压缩或加密)。把这条排除掉之后,就不会再往"直接 dump 出来就能用"的方向浪费时间。
二、断下 buf 读取
读了自身的 buf,接下来要做的事情不言而喻:把存在自身的文件输出出去。
断点打上,然后是漫长而折磨的堆栈跟踪——从系统调用一层层爬回业务代码。
这一步的运气成分不小:函数名没有被混淆。所以爬上去之后直接就能读到语义,不需要从寄存器组合反推这个函数在干什么。如果碰上混淆,这段路的成本会翻好几倍,而且未必走得通。
爬上去看到的东西也值得记一笔。同一个动作存在好几个变体——带云字样的、带 Ex 字样的,名字都极像正主。但这几个变体一次都没被调用过,判断依据就是断点根本停不住。
所以只分析真正执行的那两个函数,其余全部放掉。这个取舍省下的时间比想象中多:**不执行的路径你分析得再透,对这个包的还原也没有贡献。**人很容易在"名字看起来很重要"的函数上耗时间,而调用次数才是唯一的裁判。
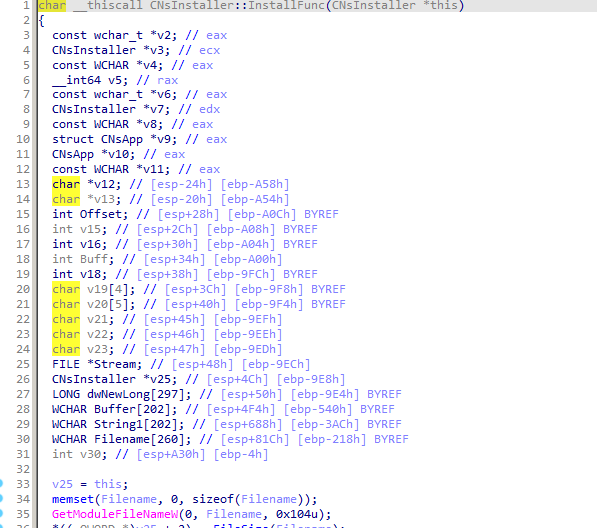
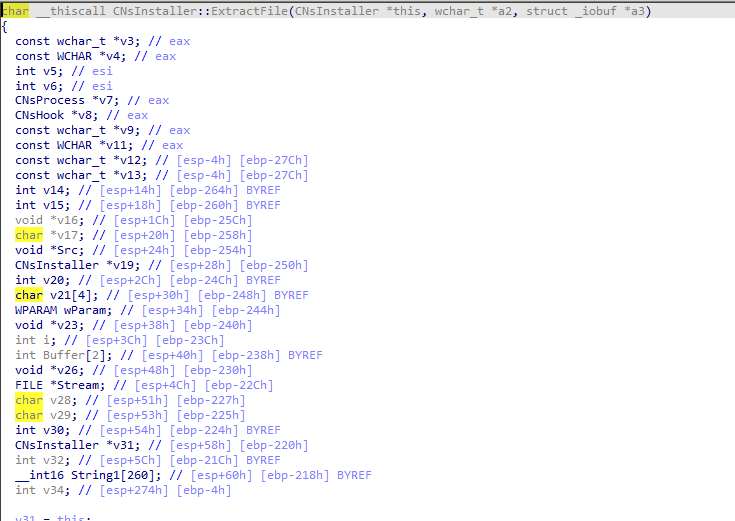
CNsInstaller::InstallFunc   ← 外层,每轮产出一个文件
CNsInstaller::ExtractFile   ← 内层,每轮给文件补一段数据
三、IDA 静态分析
经过断点调试和堆栈回溯,两个重要函数拿到之后,分析目标就明确了。
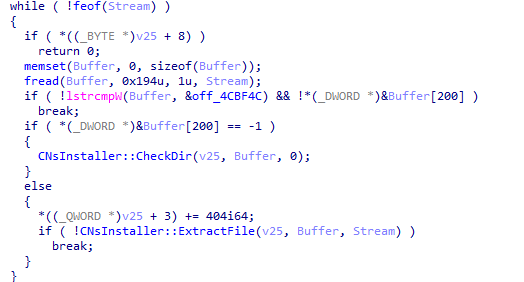
在 IDA 里看这两个函数,双层循环的结构一眼就能认出来:
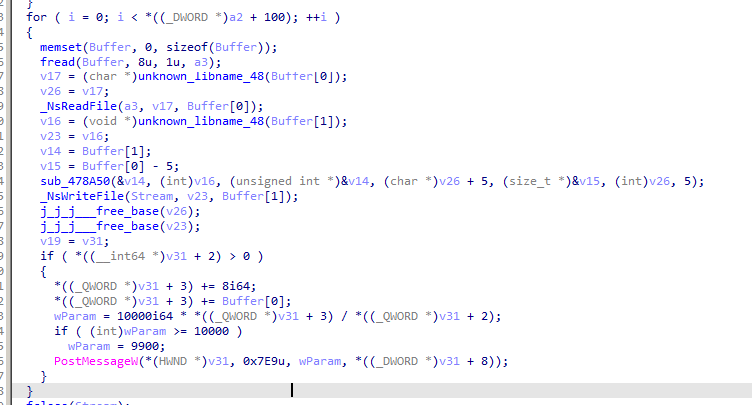
第一个循环在 install 里面,是文件循环,每次循环生成一个文件;第二个循环在 extract 里面,是数据循环,每次循环为文件添加一部分数据。
while ( !_feof(Stream) )                      // 文件循环
{
    fread(Buffer, 0x194, 1u, Stream);         // 一条文件头,定长 0x194
    if ( !_lstrcmpi(Buffer, &off_4CBF4C) && !*(DWORD*)&Buffer[200] )
        break;                                // 结束标记
    if ( *(DWORD*)&Buffer[200] == -1 )
        CNsInstaller::CheckDir(v25, Buffer, 0);   // 是目录
    else
        CNsInstaller::ExtractFile(v25, Buffer, Stream);
}
到这里,“猜字段含义"这件事才真正有着力点。因为循环层数一旦确认,每个循环入口读的那块固定长度数据就必然是头部,而头部里长度不固定的那段大概率是名字。反过来,如果先不去确认循环结构、直接对着一堆字节猜字段,基本是在猜谜。
四、漫长的分析
当寻找到准确的函数,并且它没有混淆、没有加密的时候,最困难的工作已经做好了。剩下的就是猜测、分析、验证、推翻、重新猜测的循环。
这一部分没有技巧可言,但有两处判断值得单独拿出来。
**一是"看起来像边界的地方,往往不是”。**内嵌文件之间的分隔标记,前后断了四次才收敛:
| 次序 | 位置 | 错在哪 |
|---|---|---|
| 第一次 | 0047A45E | 那是程序自身的标注,不是数据边界 |
| 第二次 | 0047999B | 分割区 1 和 2 划分错误,尾部的 00 应该归到分割区 2 |
| 第三次 | 00478C59 | 只读入了一个字节,而且它和解码数据处于同一个函数 |
| 第四次 | 00478D10 | 这才是真正解码数据的位置 |
前三次每一个都"看起来很像”。这种位置靠一次断点是确认不了的,只能反复验证。
**二是字段含义要落到结构体上才算真的懂了。**最后钉下来的格式:
| 部位 | 长度 / 判据 | 含义 |
|---|---|---|
| 元数据块 | 0x15C8 | 包级头部,紧随基址 |
| 文件头 | 0x194 | 每个文件一条,循环读取 |
| ↳ 名字 | 头部前 0x190 | 文件或目录名 |
| ↳ 时间戳 | +0x190,4 字节 | |
| ↳ 是否目录 | +0xC8 处取值为 -1 | 目录标志 |
| ↳ 分片数 | 决定内层数据循环跑几轮 | |
| 数据头 | 0x8 | 每片数据前的短头 |
| ↳ 有效数据 | 数据头 +5 起 | 喂给解压函数 |
| 文件长度 | 小端模式倒序存储 |
基址本身有两个值,0x120200 和 0x136400,对应两个不同的样本包。代码里那两行并排的 #define 注释就是这件事留下的痕迹——同一套分析在两个样本上各走了一遍,第二个基址变了,其余结构完全一致。“换个包还成不成立"这件事,是在这一步就开始验的,不是最后才补。
五、LZMA 的压缩分析
通过数据头的特征,最后猜测到了 LZMA 的压缩方案,并且通过验证确认了这一点。
验证方式很朴素:拿数据头之后偏移 5 字节的位置作为输入,调 LzmaUncompress,能解出正常内容就成立;不成立就换假设。
LzmaUncompress(outBuf, &outBufLen, p->fileData + 5,
               &fileDataBufLenMinus5, p->fileData, 5);
对参数进行复刻,对程序进行复刻。这部分就挺简单的了——前期的寻找比较折磨,寻找到目标点以后编写 payload 就相对简单。
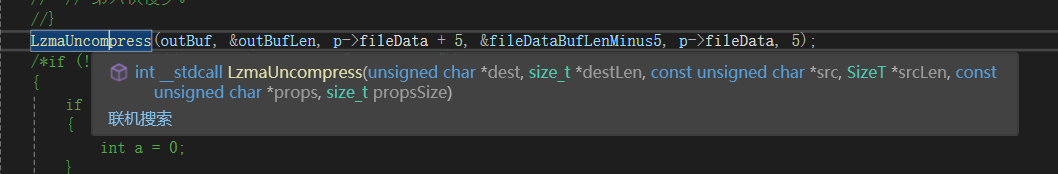
还原的最后一环是目录:文件头里带目录标志的那些,用 createRecursionDir 递归建出来,其余按名字落到对应路径下。少了这一步,一个有层级结构的包解出来会是一堆平铺的、名字里带反斜杠的怪文件。
六、验收:跑两遍,比清单
程序写完不算完。我的做法是让它把包内所有文件的元信息全量打出来——基址、数据区起点、每个文件头位置、是否目录、文件名、压缩后长度:
baseStartPos: 0x120200
fileDataStart: 0x121964
fileStartPos: 0x1217c8          isFolder: 0
fileName: uninst.exe            fileZipSize: 0x38a7a
然后在两个基址上各跑一遍,逐行对齐。对得上,才说明这套结构不是只对眼前这个包过拟合。
这一步和"抓完一本书要数文件数"是同一件事:跑完不等于跑对,得有一个独立于程序自身的判据。
七、一处试手废在哪
同一件事我当时还顺手写了个 python 版,废了。原因值得记:
- 它读那个
.lzma样本,然后调zlib.decompress去解。数据是 LZMA,不是 zlib,方向从第一步就是错的。 - 另一个反向的
zip()函数用了lzma.compress,但整个文件只import zlib,从未导入lzma。也就是说这个函数从来没成功跑过。
结论不客气:**能读通格式,和能写通还原,是两件事。**最后走通的是那份 260 行的 C++,python 那份只是个试手残留,我在仓库里把它原样留着了——留着比删掉有用,它能提醒我别把"我猜是这样"当成"我验过是这样”。
代码、偏移笔记、以及加密后的样本都在这个仓:https://cnb.cool/t1mmoc/tspace/pwngore/h7-installer-unpack
收尾
回看这四条任务,真正起作用的是五个动作,以及它们的先后:
用体积异常当入口 → 用系统调用断点让程序自报读取行为 → 只分析真正被执行的那条路径 → 先确认循环层数再猜字段 → 用否定性结论(搜不到明文、解不出内容)缩小变换范围
外加一条纪律:格式复刻完,换第二个样本再跑一遍。只对眼前这个包成立的"格式",通常只是我把它的字节抄了一遍。