起因:搜索框不认识同义词
站内搜索一直是 PaperMod 自带的 Fuse。它做字面匹配,好用、快、零成本,但只认字。
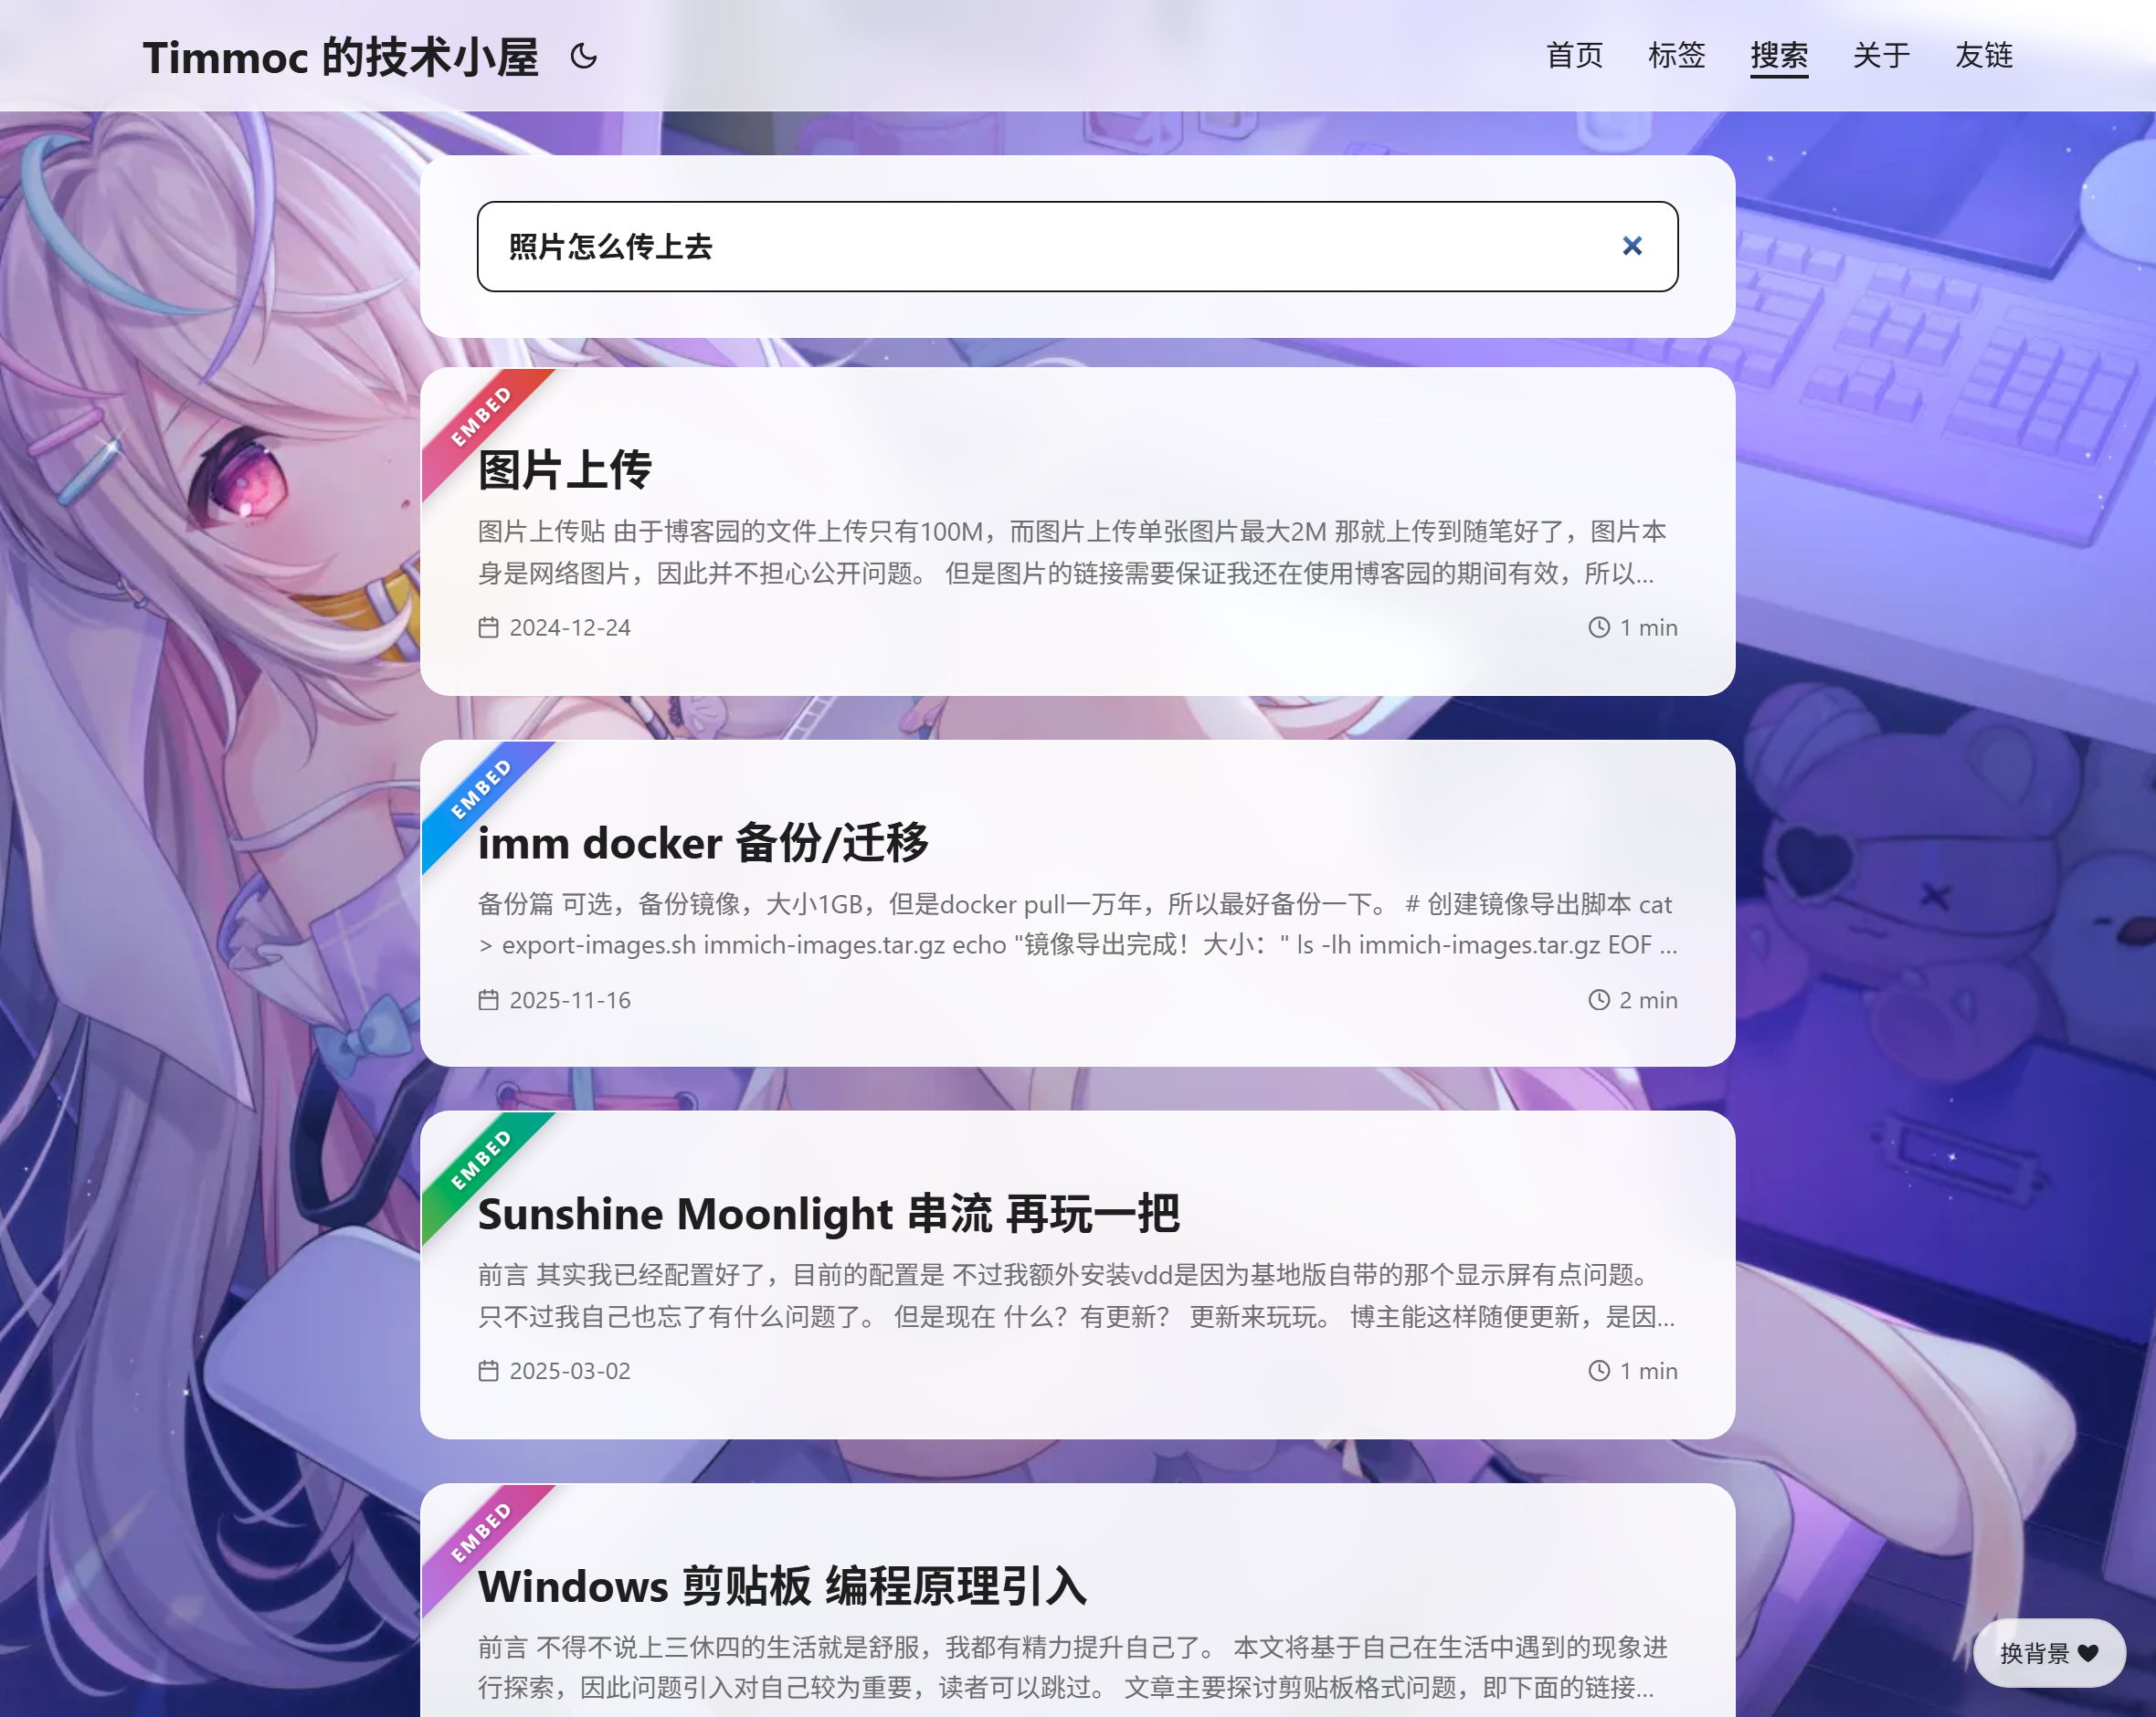
我搜「照片怎么传上去」,答案是《图片上传》——它对不上。搜「多个人分密钥保管」,正解是《Shamir 秘密共享方案》——它也对不上。这不是参数没调好,是方法本身没有这个能力:字面匹配不知道「照片」和「图片」是一回事。
所以真正的需求是四条,写下来免得做着做着跑偏:
- 近义 / 口语化的说法也能命中;
- 输入即出关键词结果,不能为了语义把首屏拖慢;
- 两种结果合成一个列表,不能是「关键词一段、语义一段」;
- 语义那层挂掉时,搜索依然可用。
先定分工:谁快谁先出
先把两条路的速度量出来,再决定怎么拼:
| 路径 | 耗时 | 成本 | 依赖 |
|---|---|---|---|
| Fuse 字面匹配 | ~220ms(含 120ms 去抖) | 0 | 本地,索引 850KB 随页面加载 |
| 语义向量 | ~1.0s(模型 100–300ms,其余是链路) | 极小 | 一次跨网请求 |
差了五倍,那就别争谁替代谁:关键词永远先渲染,语义结果到了再合并。语义慢、语义挂,都不影响你已经看到的那一屏。
这也是我后来所有设计的约束条件——慢的那层不许挡住快的那层。
三块拼图
一、查询向量:自建 Worker
查询词要变成向量,模型用 Cloudflare Workers AI 的 bge-m3(多语言、1024 维、中文表现够用)。这里没有直接让浏览器调 CF 的 AI 接口,而是包了一层自己的 Worker,两个原因:
- token 不下发前端。浏览器直连就得把 API token 塞进页面,等于公开;
- 避开
*.workers.dev。那个域名在大陆基本不可达,挂个自定义域名search.tmoc.qzz.io才稳。
接口很小:
POST /embed  {"q": "电脑很卡怎么办"}
  → {"ok": true, "d": "<int8 base64>", "s": 0.031, "n": 12.4, "ms": 123}
d 不是 1024 个浮点数的 JSON 数组(那样一条就 8KB),而是 int8 量化后 base64——1364 个字符,配 s(量化缩放)和 n(原始范数)就能还原余弦。一次查询回包 1.4KB。
Worker 上还有两道闸:CORS 白名单(只放自己的域名和本地 1313),以及每 IP 每分钟 120 次的内存级限流——内存计数不落 KV,省配额,也够挡脚本刷。
二、构建期索引:文章向量不进运行时
如果每次搜索都现场算文章向量,一次请求要 100 篇 × 1500 字,慢且贵。所以文章向量在构建期算好,跟着静态站一起发布:hugo --minify 之后跑一个 Node 脚本读 public/index.json,批量调同一套 API,产出 search-vectors.json。
两个细节值得记:
- 每篇存两条向量:标题一条、正文(标题+摘要+前 1500 字)一条。后面打分时用得上;
- 加密文章的正文本来就不在
.Plain里,所以加密文只会以标题和摘要进索引——这条边界不用特意处理,是数据结构自带的。
现在 99 篇文章、198 条向量,索引文件 282KB,gzip 之后 100KB 出头。前端不在首屏加载它,而是 requestIdleCallback 空闲时预取,用户第一次敲字时正好就绪。
三、前端:覆盖主题的 fastsearch.js
PaperMod 的搜索脚本路径是 assets/js/fastsearch.js,Hugo 的 resources.Get 项目优先——所以放一个同名文件在项目里,就把主题那份替掉了,head.html 一行不用改。
这一条是有代价的教训换来的:最开始我另起了一个 layout 名,等于把搜索页从主题的设计演进里切出去;后来主题那边改了搜索页样式,我这边的副本就落后了。能用同名覆盖的地方,别另起一套。
打分:为什么最后是 max(标题, 正文)
同一批 20 条近义查询,四种打分实测:
| 方案 | P@1 | P@3 |
|---|---|---|
| 只用正文向量 | 16/20 | 20/20 |
| 只用标题向量 | 17/20 | 18/20 |
| 0.6 × 正文 + 0.4 × 标题 | 18/20 | 19/20 |
| max(标题余弦, 正文余弦) | 19/20 | 20/20 |
直觉上「加权平均」更像正经做法,实测反而差:长正文把标题那点锐度稀释掉了。而两条向量本来测的就是「这篇讲什么」,取更大的那个更像人在判断——标题对上了就是标题对上了。
剩下那 1 条错的也有意思:搜「打包文件名一串乱码」,PECMD的解包 和 vite build 取消 hash 余弦只差 0.003,模型认为两篇都在讲「二进制/打包」,这个量级的分差我认了。
融合:RRF,别把两种分数直接相加
Fuse 的 score 是「越小越像」,余弦是「越大越像」,量纲还不同,硬加必然出怪。所以用 RRF(Reciprocal Rank Fusion)——只看名次:
score = 1.0 / (15 + 关键词名次) + 1.15 / (15 + 语义名次)
语义权重给 1.15,是因为关键词命中通常已经很准,而语义的价值在于把「字面没中但意思对」的捞上来。余弦低于 0.36 的语义结果直接丢,不让噪声进场。
出来的就是一个单列表,没有「关键词段 / 语义段」的分界。
降级:这次真被它救了
语义那层的失败处理写了三层:3 秒超时、失败后 20 秒(连续两次失败 60 秒)冷却、任何异常都退回纯关键词。
然后它在生产上真的挂了一次,而且挂得很难看:
CI 里生成向量时撞上 Workers AI 的
408 Request timeout,脚本按设计「软失败退出 0」,站点照常发布——于是线上没有search-vectors.json(404),语义检索静默关闭,用户搜近义词直接 0 结果。
设计上是对的(降级可用优于发布失败),但它把「不可用」做得太安静了。修法三条:
- 408 / 429 / 5xx 退避重试三次,整批失败再退化成逐条请求;
- 批大小从 6 降到 4,单请求 token 少一半,超时概率低一个量级;
- 软失败时打
::warning::annotation,构建摘要里能直接看见,不再是日志深处的一行。
降级路径必须留信号,否则「优雅降级」等于「悄悄失效」。这是我这次最想留下的一条。
输入成本:打字到底会不会烧钱
一开始我也担心:一直打字,是不是每个字都发一次请求、把 Workers AI 的免费额度打光。实测计数(拦 /embed 数次数):
| 输入方式 | embed 请求数 |
|---|---|
| 连打 5 字(60ms/字) | 1 |
| 慢打,每字停 300ms | 3(每次停顿算一次稳定查询) |
| 中文输入法拼音未上屏 | 0(上屏后才发 1 次) |
| 同一词删掉重打 | 0(命中缓存) |
链路是:每个字符只走本地 Fuse(120ms 去抖),语义在停手 220ms 后最多发一次。另外补了两个洞——输入法 compositionstart/end 期间直接跳过(原先拼音没上屏就可能拿 zhaopian 去算向量,白花钱且结果没意义),以及会话内缓存最近 50 个查询的向量。
成本量级:bge-m3 按 1075 neurons / 100 万 input tokens 计费,免费额度 1 万 neurons/天 ≈ 930 万 tokens。一次短查询 10–20 tokens,约 0.01 neurons,够搜 46 万次。真正会烧的是被人拿脚本刷接口,那个有 IP 限流挡着。
Embed 缎带:让人知道这条不是你打的字命中的
功能能用了,还剩一个观感问题:语义捞上来的结果,和关键词命中的结果,混在一个列表里长得一模一样。用户会疑惑「我搜的词它标题里根本没有,为什么排第一」。
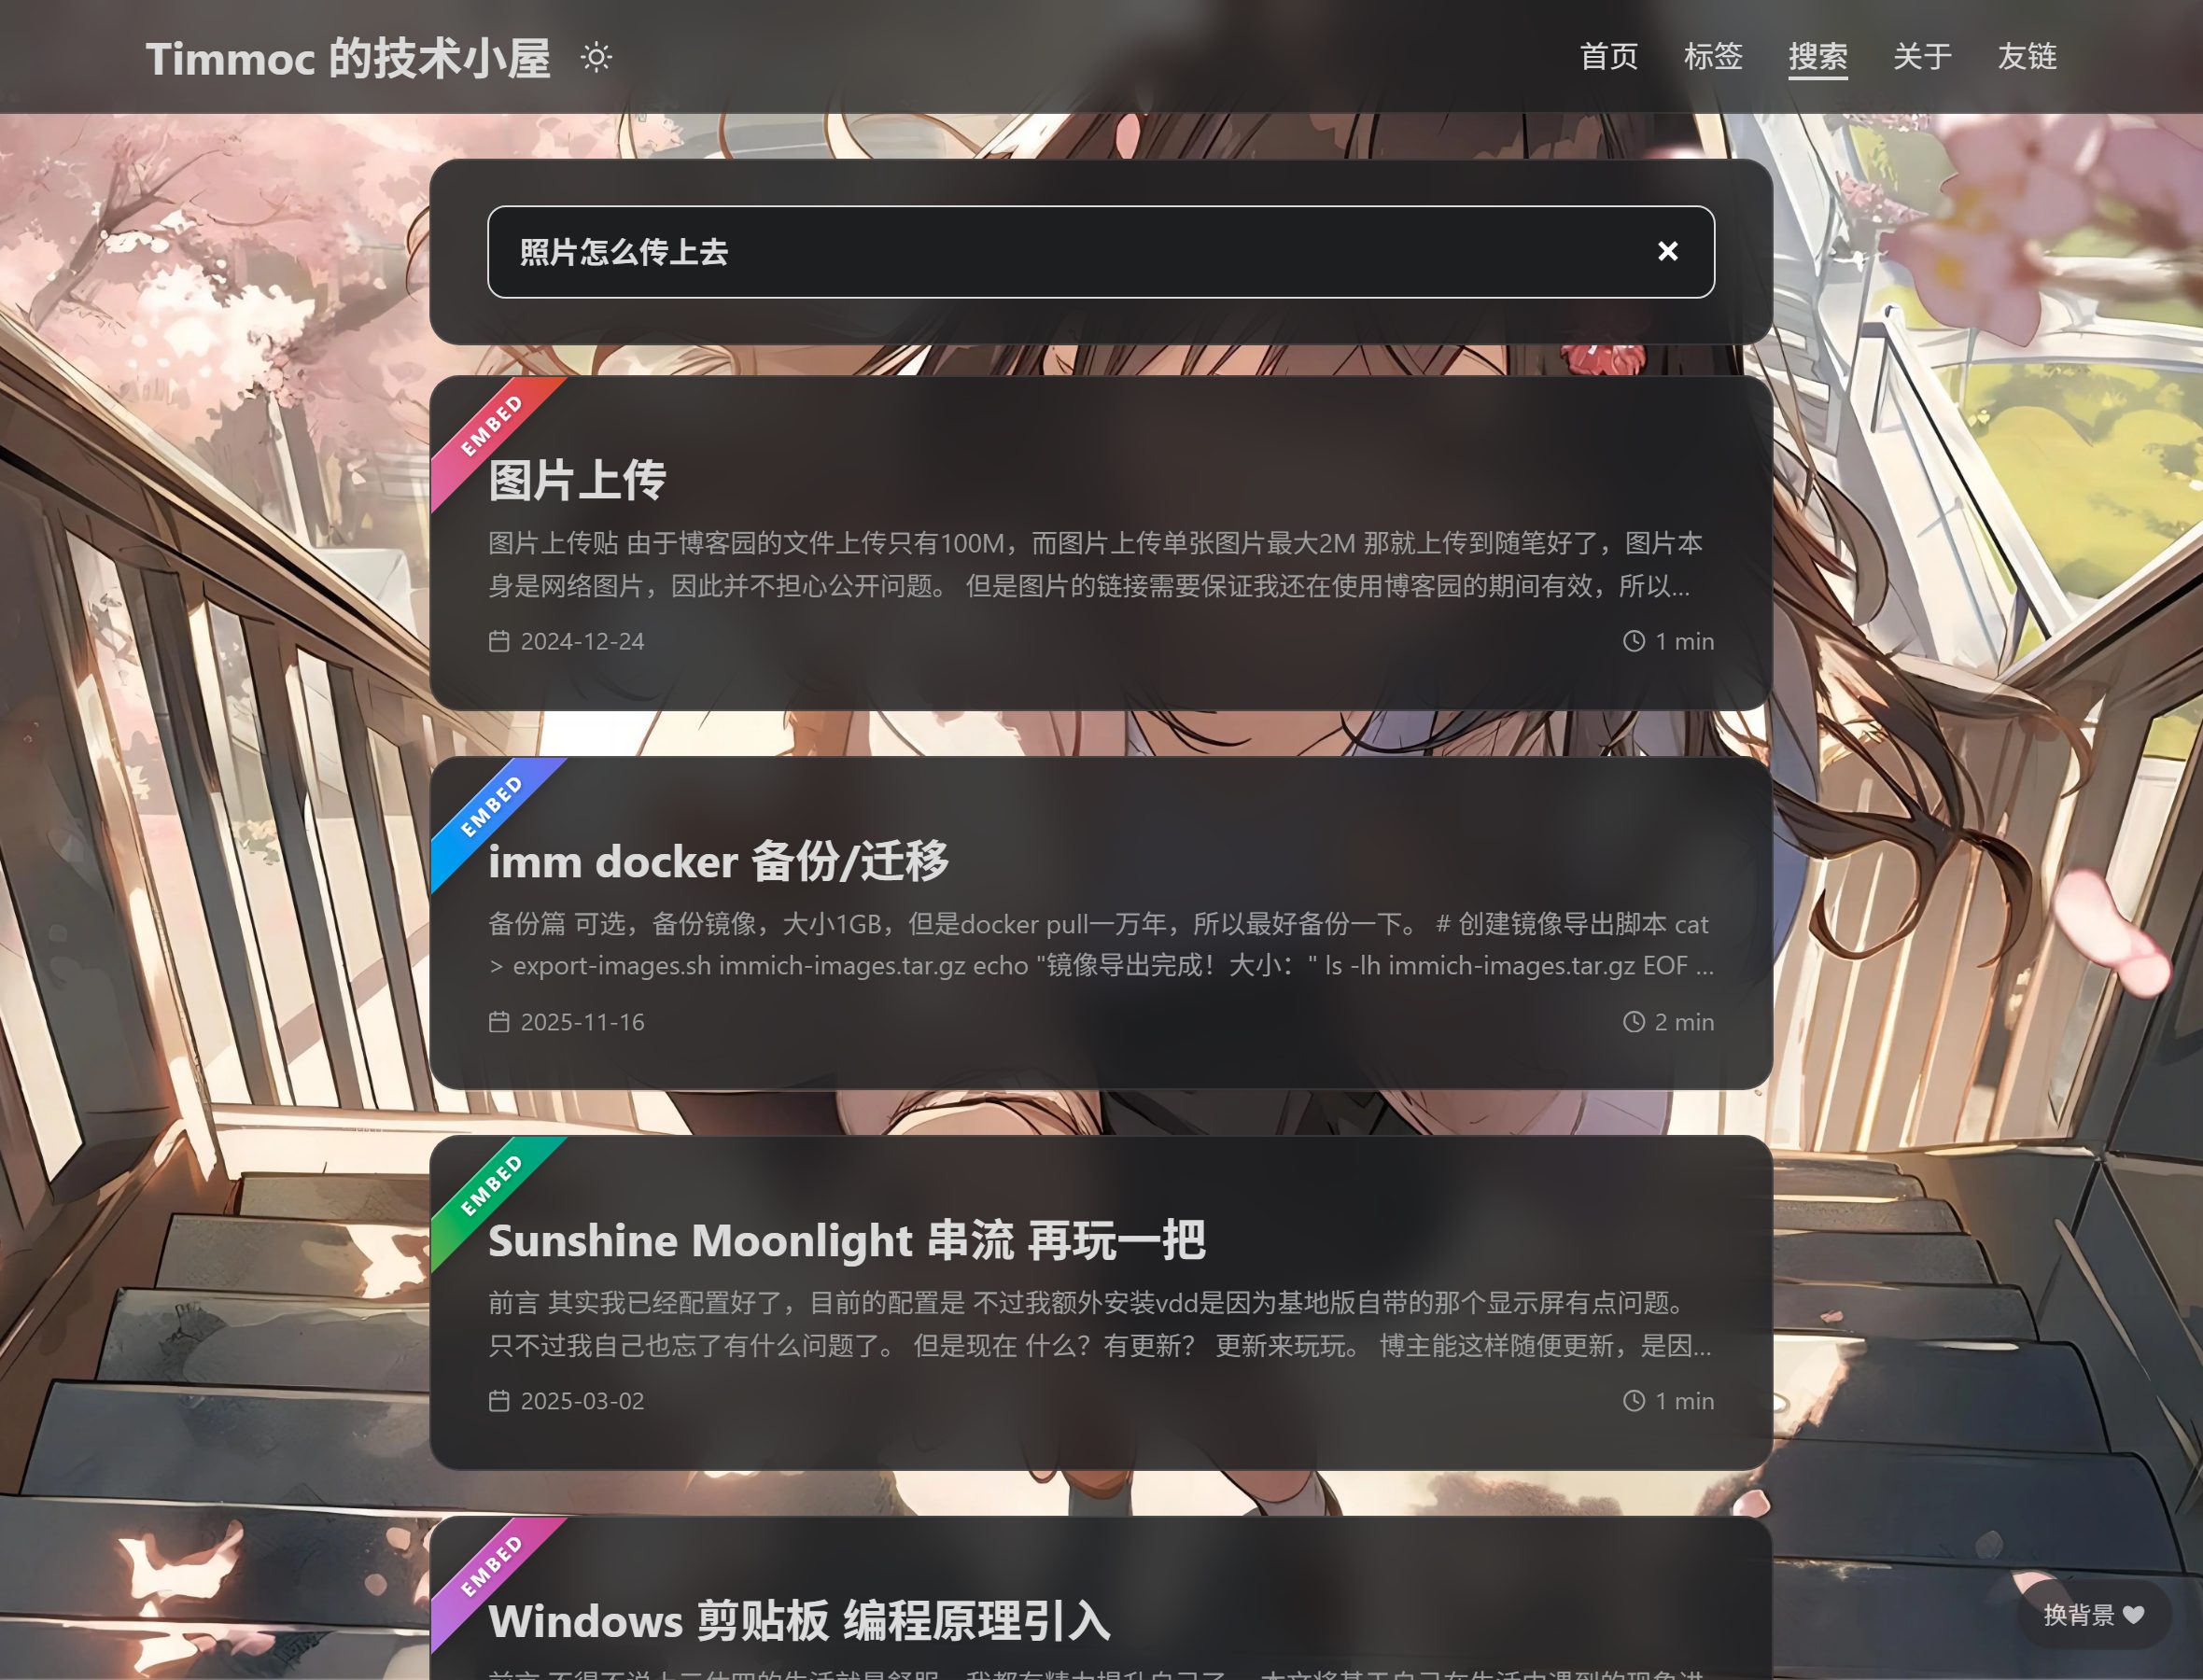
解决办法是给语义命中的卡片挂一条缎带,上面写 Embed——一眼看出来:这条是词义分析的功劳,不是你输入的字面命中。
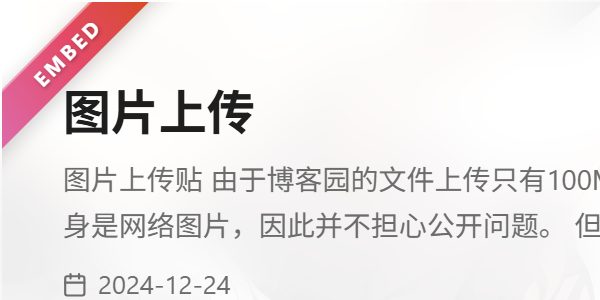
颜色不能是随机的每次变,也不能是固定一种(一片卡片全粉就白挂了)。沿用博客标签那套确定性配色:标题 → FNV-1a 哈希 → 名次 × 137.5072°(黄金角)→ 色相,落在 OKLCH 里固定 L/C。同一篇文章永远同色,不同文章铺得均匀——和标签页用的是同一个原理,只是这次不按权重分亮度档,好看就行。
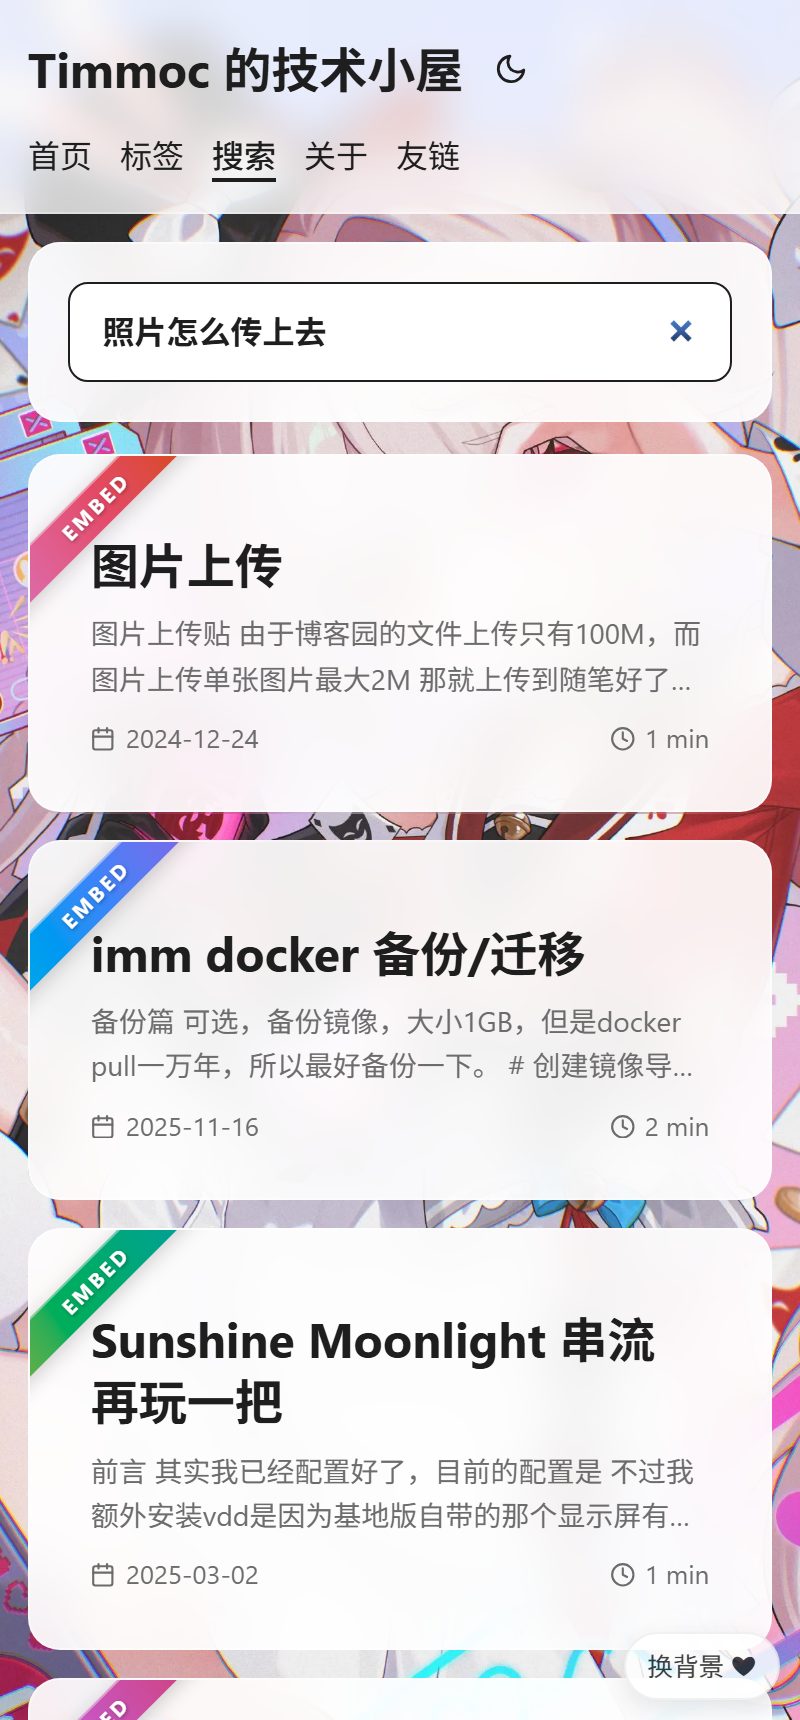
缎带本身是 45° 斜带贴在左上圆角上,白字加一点内高光当缎面。踩了两个小坑:一开始在角上加了个折角三角,看着像多出来的小角标,删掉了;斜带位置偏高会压住标题首字,最后用几何算的——带下沿在标题左缘处 y≈28.6px、标题 top=40px,留 11px 净空。
移动端卡片压到 400px 宽时缎带也还站得住:
语义在路上时,界面得有交代
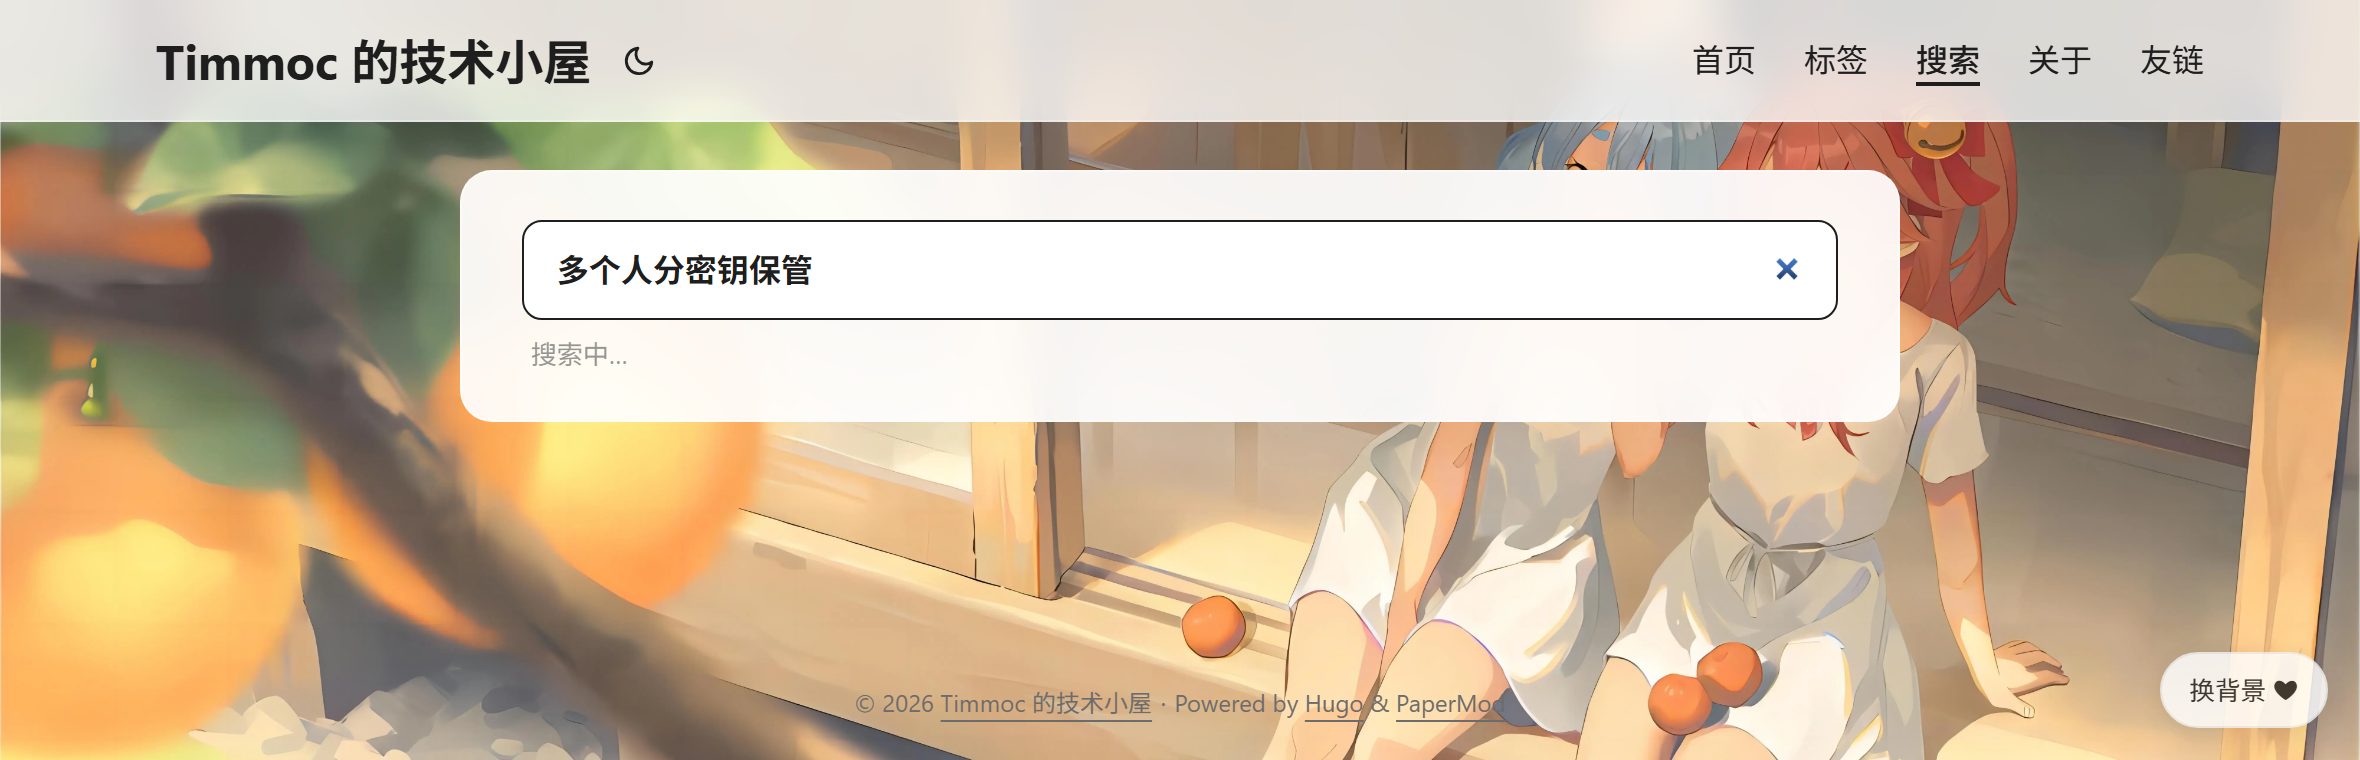
既然语义要一秒,这一秒不能是空白。搜索框下面挂一行极轻的「搜索中…」,只在请求在飞时出现,落定即消失;关键词结果不受影响,该出的一条不少。
这次带走的三条
- 慢的那层不许挡住快的那层。 关键词 220ms 已经出结果了,语义 1 秒能追上来就追,追不上也不影响可用性。
- 降级路径必须留可见信号。 「失败了也照常发布」听起来很稳,但如果没人知道它失败了,就等于一条永远静默的死路。
- 索引是构建期的活,别塞进运行时。 100 篇 1500 字的向量,构建期算一次、发布成静态文件、前端空闲预取,比每次搜索现算便宜两个数量级。