需求是三句话,难点只在第三句
让 AI 重做博客标签的配色,我给的要求是三条:
- 每个标签颜色不同,要五颜六色;
- 颜色由标签自己的值决定 —— 同一个标签文字,在任何页面必须是同一个颜色;
- 标签后面的数字(该标签下的文章数)越大,越要吸引人。
做完是这个样子 —— 逆向(12 篇)顶格,TOC、火绒剑 那批 1 篇的几乎融进盘子里:
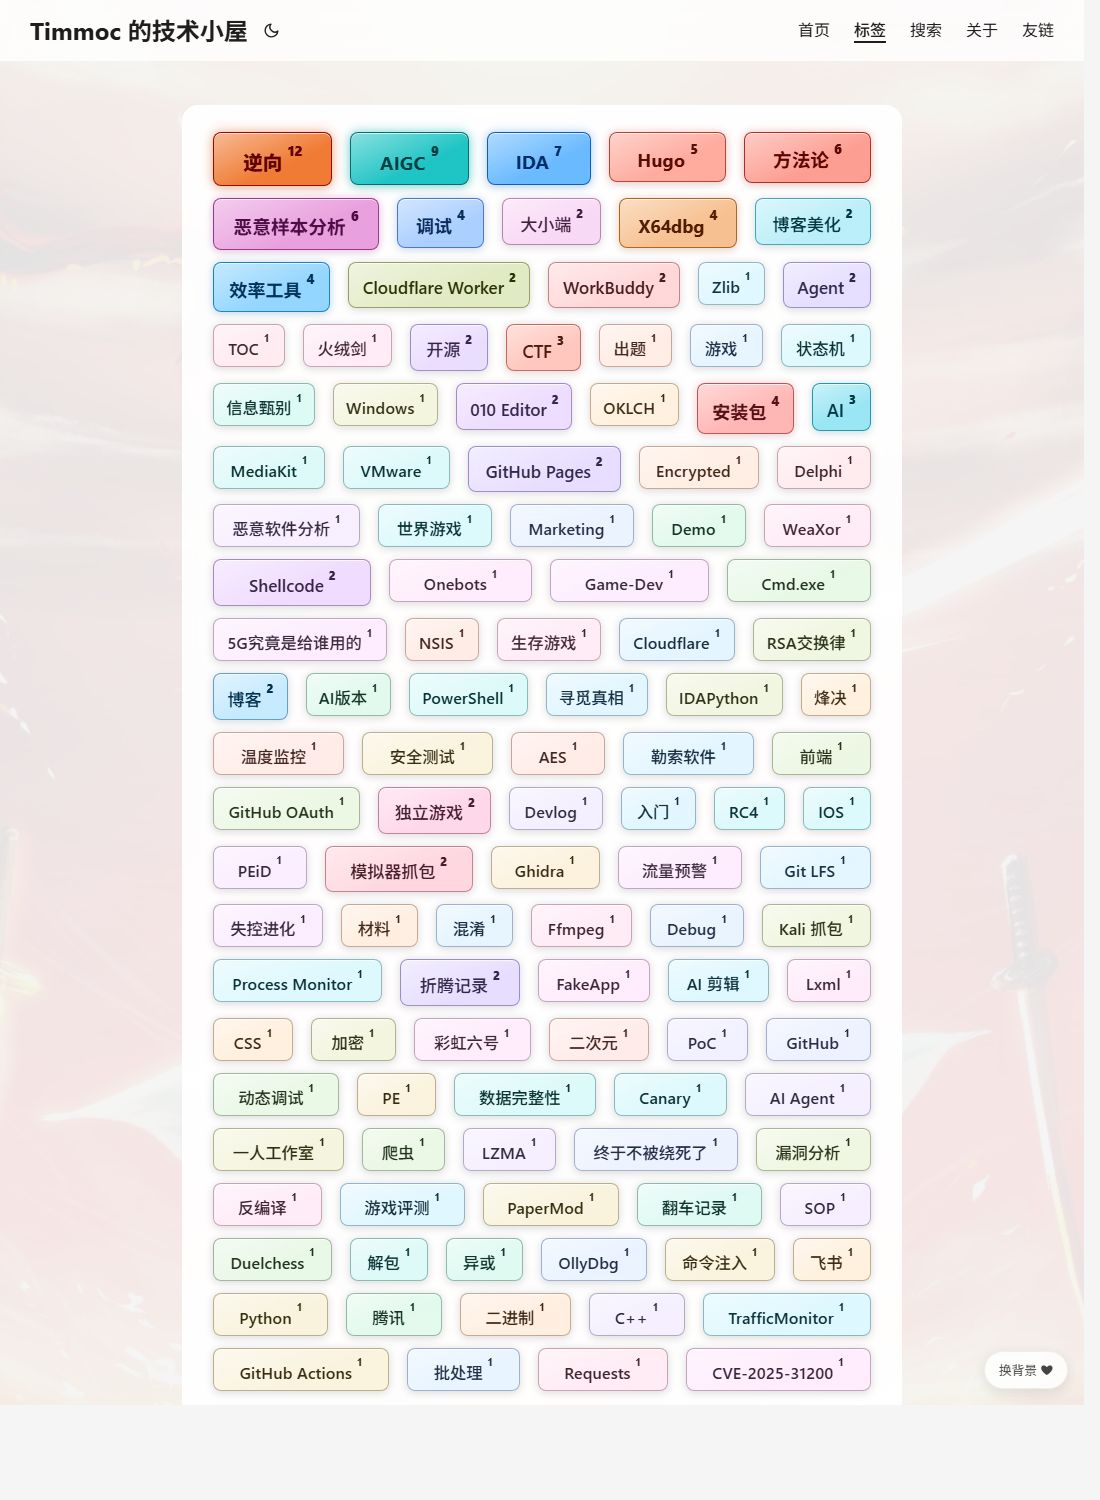
前两条一句话就能实现:拿标签文字做一次哈希,映射到色相环上就完事。真正要想的是第三条 —— “越吸引人"到底是颜色的哪个值?
脱口而出的答案是"饱和度”。但这个答案不合格,因为饱和度只解释"艳不艳",不解释"跳不跳"。我把问题反过来问:一个元素被人眼最先扫到,靠的是哪些可分离的量?列出来是五个通道:
- 与它背后那块底的感知亮度差(ΔL)
- 彩度(离灰有多远)
- 填充实度(透不透,也就是"离背景多远")
- 字重
- 字号 / 体积(这一档做过又撤掉,原因见下)
先把形容词换成通道清单,后面每一步才有东西可测。这一步是整个事情的地基:判据不定,返工就没有终点。
字号那一档的撤回值得单说:我确实让标签盘里数字大的同时放大到 +0.22rem、内边距也跟着加。撤掉是因为它把一行搞乱了 —— 同一行里高低不齐、长短不一,“体积"在成排摆放时买到的注意力,远不如它带来的凌乱。所以最终全员等高、宽度只由文字决定,权重只走颜色与字重,行内的富余全部插进间距。
HSL 的 L 不是感知量
第一版用 HSL 做完,两个症状同时出现:逆向¹²(12 篇,权重顶格)绿得像荧光棒,而 安装包⁴(4 篇)闷在卡片里看不见。
根因不在参数调得不好,在 HSL 这个空间本身。HSL 是把 RGB 立方体硬掰成圆柱得到的坐标,它的 L 只是"红绿蓝三个分量各占多少"的算术平均,不是人眼感受到的亮度。同一个 L=58%、按各自权重合成到毛玻璃底上之后:
| 彩签(HSL 时代) | 色相 | 填充 α | 合成后相对亮度 Y |
|---|---|---|---|
| 1 篇 · 黄绿 | H=74° | 0.20 | 0.838 |
| 6 篇 · 蓝紫 | H=273° | 0.41 | 0.524 |
| 12 篇 · 黄绿 | H=74° | 0.66 | 0.818 |
后果是方向都要看色相:浅色主题里"跳"意味着比底更暗,于是 1 篇的黄绿(Y=0.838)比 6 篇的蓝紫(Y=0.524)还贴白底、更不跳;深色主题里"跳"意味着比底更亮,黄绿又天然占尽便宜 —— 逆向¹² 那颗荧光绿就是这么来的。同一个"数字大 → 更跳"的规则,在 HSL 里会被色相改写成"看情况”。
我的第一反应是打补丁 —— 给黄绿区(H 60~160)按余弦衰减压暗、压饱和、砍发光。补丁能上,但它治的是症状:在用第二个近似去修第一个近似的误差。
换 OKLCH 才是治这个的。它的 L 就是感知亮度,C 就是彩度,H 才是色相,三者真正正交。换完以后同一文章数的所有标签,ΔL 是同一个值,不再随色相漂移:
| 篇数 | 枚数 | 权重 w | ΔL(浅色) | ΔL(深色) | 彩度 C | 填充实度 α | 字重 | 相邻 Δw |
|---|---|---|---|---|---|---|---|---|
| 1 | 91 | 0.083 | 0.022 | 0.015 | 0.056 | 0.54 | 525 | — |
| 2 | 13 | 0.301 | 0.081 | 0.054 | 0.086 | 0.64 | 590 | +0.218 |
| 3 | 2 | 0.456 | 0.123 | 0.082 | 0.107 | 0.71 | 637 | +0.155 |
| 4 | 4 | 0.576 | 0.156 | 0.104 | 0.123 | 0.76 | 673 | +0.120 |
| 5 | 1 | 0.674 | 0.182 | 0.121 | 0.136 | 0.80 | 702 | +0.098 |
| 6 | 2 | 0.757 | 0.204 | 0.136 | 0.147 | 0.84 | 727 | +0.083 |
| 7 | 1 | 0.829 | 0.224 | 0.149 | 0.157 | 0.87 | 749 | +0.072 |
| 8 | 0 | 0.892 | 0.241 | 0.161 | 0.165 | 0.90 | 768 | +0.063 |
| 9 | 1 | 0.949 | 0.256 | 0.171 | 0.173 | 0.93 | 785 | +0.057 |
| 10 | 0 | 1.000 | 0.270 | 0.180 | 0.180 | 0.95 | 800 | +0.051 |
| 11 | 0 | 1.000 | 0.270 | 0.180 | 0.180 | 0.95 | 800 | +0.000 |
| 12 | 1 | 1.000 | 0.270 | 0.180 | 0.180 | 0.95 | 800 | +0.000 |
这张表就是"显眼"的最终定义:四个通道全部由同一个权重 w 单调驱动(字号那一档撤了,见上),任何人看一眼就能核对某一档是不是比上一档跳。
亮度带的端点不是审美决定的
ΔL 不能无限拉。彩签上的字要能读,而 WCAG 的对比度是按相对亮度 Y 算的,OKLCH 里 Y ≈ L³ —— 感知上"差一点点"的两档亮度,对比度会掉得比想象快。
所以填充亮度的上下限不是我看着顺眼定的,是扫出来的:72 个色相 × 21 档权重,逐格把 OKLCH 转成 sRGB(超出色域就按 CSS Color 4 那样收敛彩度),算文字与彩签底色的对比度,取最差值,再二分找临界。结论:
- 浅色主题:文字固定
L=0.30,填充亮度带0.95 → 0.68,全程最差 4.56:1(落在 H=5° 的橙红上); - 深色主题:文字固定
L=0.96,填充亮度带0.32 → 0.50,全程最差 5.11:1。
整站 116 枚实测最低 4.79 / 5.92,全部过 AA。
顺带一个必须写清楚的天花板:深色主题能拉的 ΔL 跨度天生比浅色小(0.18 对 0.27)。因为白字要压得住,填充最多走到 0.50,再亮对比度就崩。所以深色下高数字标签的"跳",得靠彩度、填充实度和外发光多扛一点 —— 这是空间的边界,不是实现没做好。
同名必同色:哈希、黄金角、以及在哪里收手
色相由标签文字哈希得出,天然满足"同名必同色",而且新增标签不会改动别人的颜色。但直接 hash % 360 会把 116 枚挤得疏密不均,出现一批挨在一起的同色标签。换成黄金角步进:先由哈希给每个标签一个稳定的名次 rank,再 H = rank × 137.5072° mod 360。铺完之后:
全局色相差 < 8° 的配对数:290 对。而 116 枚随机均匀铺开时,这个数的期望值是 296 对 —— 黄金角铺完比"瞎撒一个哈希"还要略匀一点,色相这一维已经没有余量了。
也就是说,色相这条路基本走到头了。116 个东西摊在 360° 上,平均间距只有 3.1°,本来就低于人眼 5~10° 的色相分辨门槛 —— 想靠色相让 116 枚"全都看得出不一样"是不可能的,剩下的区分度只能由亮度、彩度、字重去承担。
这里我绕了两次远路,都值得记:
- 我先加了个"±12° 抖动"去拆散撞色的标签 —— 治标;
- 又改成保留 0.1° 小数精度,去消灭那 11 对"色相同、文章数也相同"的完全全等标签 —— 为此还得在模板里手写浮点取模绕开 Hugo 的整数
math.Mod。
第 2 步被一句话问回:“整数和浮点有太大区别吗?” 没区别。那 11 对全等标签肉眼不可见,而代价是三行难懂的表达式。区分度低于感知门槛的精度,就是纯粹的复杂度。 退回整数,把复杂度留在设计里而不是代码里。
数据是长尾的:借曲线的形状,不借它的端点
w = 篇数 / 最大篇数 这条线性映射,在别的数据上没问题,在这份数据上废了:116 枚里有 91 枚只有 1 篇,1~4 篇占了 110 枚(这两个数已经算上本篇自己新增的 OKLCH、CSS 两个标签)。线性在这段每档只差 0.083,ΔL 差 0.02,肉眼完全分不出 —— 也就是说,绝大多数标签挤在视觉上无法区分的同一档里。
第一反应是换对数:w = ln(1+n) / ln(1+10)。台阶确实挪到了数据密集的地方,但整条曲线被抬起来了 —— 1 篇标签自己就到了 0.289,满盘变艳。被打回:“太鲜艳了,1 需要浅到引入对数之前。”
正解是只要对数的形状,端点仍挂回线性:把它仿射映射到 [最小篇数/最大篇数, 1],即
g(n) = ln(1+n) / ln(1+knee)
w(n) = w_min + (1 - w_min) × (g(n) - g(min)) / (g(max) - g(min))
这样 1 篇的 w 精确等于线性时代的 0.083(ΔL 0.022,观感逐项不变),而 1→2 的跨度从 +0.083 拉到 +0.218,往上递减到 7→8 只剩 +0.063,10 篇以上封顶不再涨。低段拉开、顶端压平、底噪不动,三件事一次做完。
这个手法可以搬走:改任何"按数值映射视觉属性"的曲线时,先确认你的数据分布,再决定是换曲线还是换锚点。 长尾数据的痛点通常不是曲线不够陡,而是陡的位置不对。
立体感要分场景
同一套彩签,“要不要立体"这一维上来回改了三轮:
- 第一版全加上斜向高光、顶部内高光、外发光、托底投影 → 首页卡片那一排标签"好丑,好卡通”,一排胶囊鼓在卡片上;
- 全拆成平涂 → 标签页整盘"像贴纸",独立摆在背景上的彩签失去了玻璃的厚度;
- 最后按**“独立摆放"还是"成排贴表面”**分:标签盘和文章底部的实体彩签保留玻璃厚度(高光 + 内高光 + 随权重的外发光 + 投影),而首页/归档/文章顶部那排行内标签只做平涂,靠"填充 + 一圈描边"站立。
配套的一条:淡标签的描边不能跟着权重一起变淡。它本来就要和卡片贴在一起,边一虚就"化"进卡片里。所以描边透明度有下限(0.65),并且比填充再深 0.28 个感知亮度。
截断这种运行时行为,判据不能靠猜
最后一个是显示规则:文章内部的标签必须完整显示;首页卡片不限数量,但宽度真的不够时,尾部要折进一个 #... 假标签。
“宽度不够"是运行时才知道的事,模板算不了。做法是模板永远输出完整标签、#... 默认 display:none,运行时用 scrollWidth > clientWidth 判定不足后逐枚折尾。两个坑:
- 测量期必须同时锁住"换行"和"收缩”。 只锁外层行不够 —— 标签组自己是 flex 容器,会缩窄换行,于是外层行的
scrollWidth永远不超标,折叠判定永远不触发。看着像逻辑没生效,其实是判据被布局消化掉了。 - 判据不成立时要放弃折叠,退回换行,而不是把标签裁掉一半。折到只剩一枚还放不下,说明问题不是"数量多"而是"名字长"。
另外,文章页的容器不在折叠脚本的选择器里,也不被任何强制不换行的规则命中,所以它的自然行为就是溢出换行、永不截断。
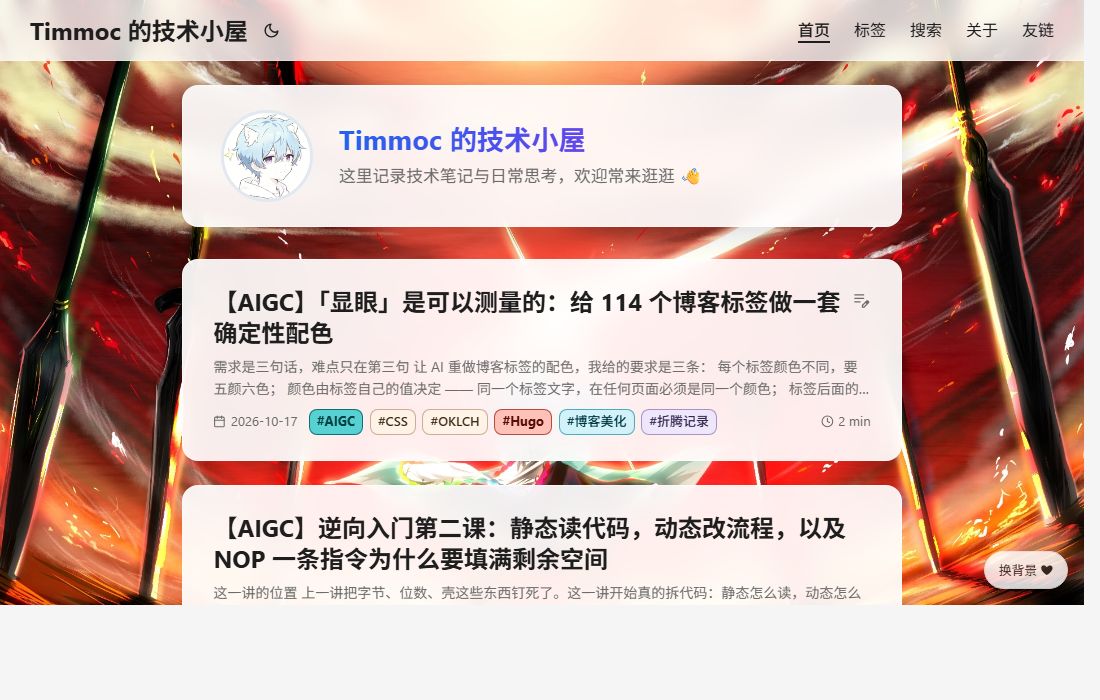
首页这两张卡片正好把两种结局都拍到了:第一张 6 枚标签放得下,就 6 枚全显示、没有 #...;第二张 8 枚放不下,折成 7 枚 + #...(悬停可看"还有 1 个标签")。
我带走的几条
- 先把主观词拆成可分离的通道并定判据,再动手调参数 —— 不然返工没有终点。
- 颜色空间要选感知均匀的(OKLCH / LCH),HSL 的 L 会在不同色相之间系统性地骗你。
- 亮度带的端点交给约束反解(扫色相 × 档位取最差值),不要交给眼睛。
- 区分度低于感知门槛的精度不要做,那是复杂度不是质量。
- 长尾数据上换曲线,通常只需要它的形状;端点要锚回原来的观感。
- 立体感按元素"独立摆放还是成排贴表面"分场景,不是一套样式全局套。
- 运行时判据要防被布局消化;判据不成立时要有退路,而不是硬裁。
顺便:这篇文章自己的标签行就是这套配色跑出来的结果 —— AIGC、OKLCH、博客美化 三个标签的颜色,由它们各自的文字哈希决定,和它们在标签页上的颜色一模一样。